Source
Les pages dont nous prenons les champs : prix, nom, stock, lien.
Des données d'autres sites, à l'horaire : prix, stock, fiches des concurrents. Le résultat arrive en tableau ou dans votre système.
Le périmètre dépend du site et de l'endroit où le résultat doit aller. La première source est un travail à part.
Les pages dont nous prenons les champs : prix, nom, stock, lien.
Contournement anti-bot et proxys là où le site les exige.
Un passage tout seul, avec une trace : quand il a réussi et combien de lignes il a rapportées.
Un tableau, un fichier, ou une écriture dans votre base, un CRM ou une API.
Si une mise en page casse la collecte, cela se voit dans le journal, pas en silence.
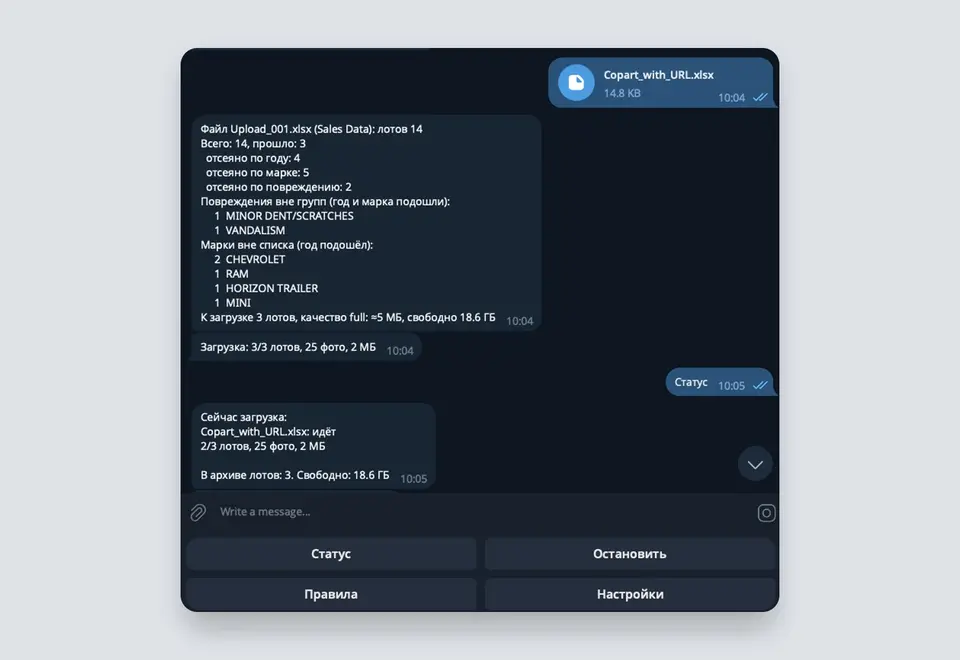
Un système pour un client qui analyse les dommages de véhicules vendus aux enchères de véhicules accidentés aux États-Unis. L'objectif : collecter les photos de milliers de lots et les organiser en une archive facile à exploiter. Ce qui a été réalisé : • Un bot Telegram : le client envoie un export d'enchères (Excel, CSV ou zip), le bot sélectionne les véhicules correspondants et télécharge toutes les photos de chaque lot. • Filtrage par année, marques et types de dommages, réglable par boutons directement dans le bot — sans développeur. • Rangement soigné : Dommage / Marque / Année / Modèle / Lot_VIN, avec pour chaque lot un fichier de données — VIN, finition, dommages, kilométrage, titre, date de vente. Les tableaux sources sont conservés tels quels, avec sommes de contrôle. • Progression en temps réel, arrêt et reprise, aucun doublon, vérification de l'espace disque avant chaque téléchargement. • Robuste face aux vrais fichiers Excel : plusieurs feuilles, CSV issus d'Excel localisé, doublons, colonnes en trop. • L'archive se monte comme un lecteur réseau sous Windows et macOS via SFTP sécurisé. • Le serveur est installé et mis à jour en une seule commande : Docker, pare-feu, protection contre le brute force, connexion uniquement par clé. Fonctionne sur un VPS de 1 Go de RAM. • 195 tests automatisés ; un déploiement s'arrête automatiquement si un seul test échoue. Résultat : à partir d'un export quotidien de 50 000 lots, le bot retient les lots pertinents et constitue l'archive — 12 à 13 photos par véhicule en moyenne, sans aucun travail manuel. Stack : Python 3.12, aiogram 3, openpyxl, Docker, Ubuntu, OpenSSH/SFTP, pytest.
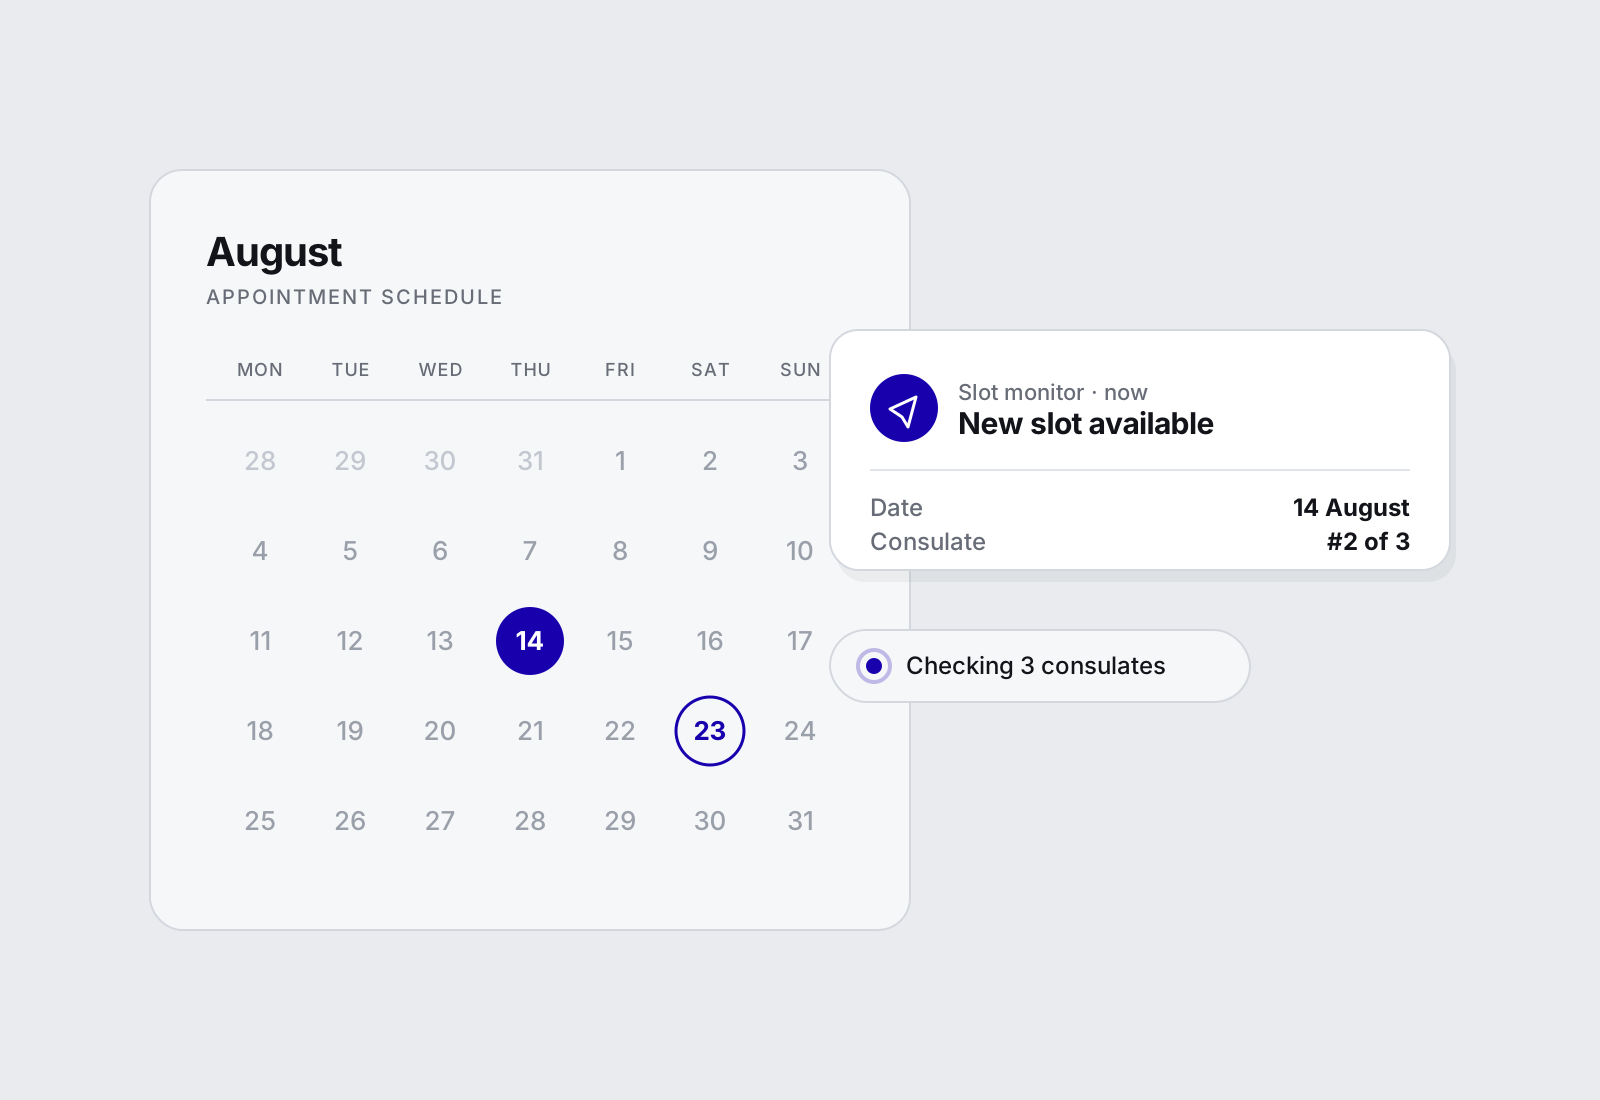
Un service pour un client qui devait être informé à temps des créneaux de rendez-vous disponibles dans les consulats de Lituanie : ils apparaissent rarement et partent vite. Ce qui a été réalisé : • Vérification régulière du calendrier de rendez-vous en ligne pour trois consulats à la fois. • Notifications Telegram dès qu'une date se libère, avec le consulat et la date. • Historique des créneaux trouvés : ce qui est apparu et quand, sans alertes répétées pour le même créneau. • Journaux détaillés et captures d'écran de la page en cas d'erreur — les problèmes sont visibles immédiatement. • Migration de Selenium vers Playwright avec une architecture asynchrone : plus stable, plus rapide et plus économe en ressources. Résultat : le client est informé d'un créneau libre quelques secondes après son apparition et a le temps de le réserver, au lieu de rafraîchir la page manuellement. Stack : Python, Playwright (auparavant Selenium), asyncio, TinyDB, Telegram Bot API.
La première source commence au montant ci-dessous. D'autres sources, et la livraison dans votre système, se chiffrent à part.
Suivi des prix, du stock ou d'un catalogue sur un site.
À partir de 300 €
Les mêmes champs de sites différents dans un seul tableau.
Sur devis
Livraison vers un tableau, un CRM ou une API, et un message si un passage s'arrête.
Sur devis
Le premier mois de support est inclus. Ensuite, sur accord — comme pour les autres prestations.
Chaque étape se termine par un résultat vérifiable.
Oui. Une source couvre un site. Les autres, et la livraison dans votre système, s'ajoutent à part.
Le passage écrit l'erreur dans le journal. Si la protection a changé, la réparation fait partie du mois de support, puis sur accord.
En général à partir de trois jours : les champs, le passage, la vérification sur des pages réelles et la passation.
Parlez-nous de votre projet : nous vous répondrons sous un jour avec des questions ou une première estimation.