Quelle
Seiten, von denen wir Felder nehmen: Preis, Name, Bestand, Link.
Daten von anderen Seiten nach Zeitplan: Preise, Bestand, Karten der Wettbewerber. Das Ergebnis kommt als Tabelle oder in Ihr System.
Der Umfang hängt von der Seite ab und davon, wohin das Ergebnis soll. Die erste Quelle ist eigene Arbeit.
Seiten, von denen wir Felder nehmen: Preis, Name, Bestand, Link.
Anti-Bot-Umgehung und Proxys, wo die Seite sie verlangt.
Ein Lauf von selbst, mit Eintrag: wann er durchlief und wie viele Zeilen er brachte.
Tabelle, Datei oder Eintrag in Ihre Basis, ins CRM oder in eine API.
Bricht ein Layout den Lauf, steht das im Protokoll und nicht still.
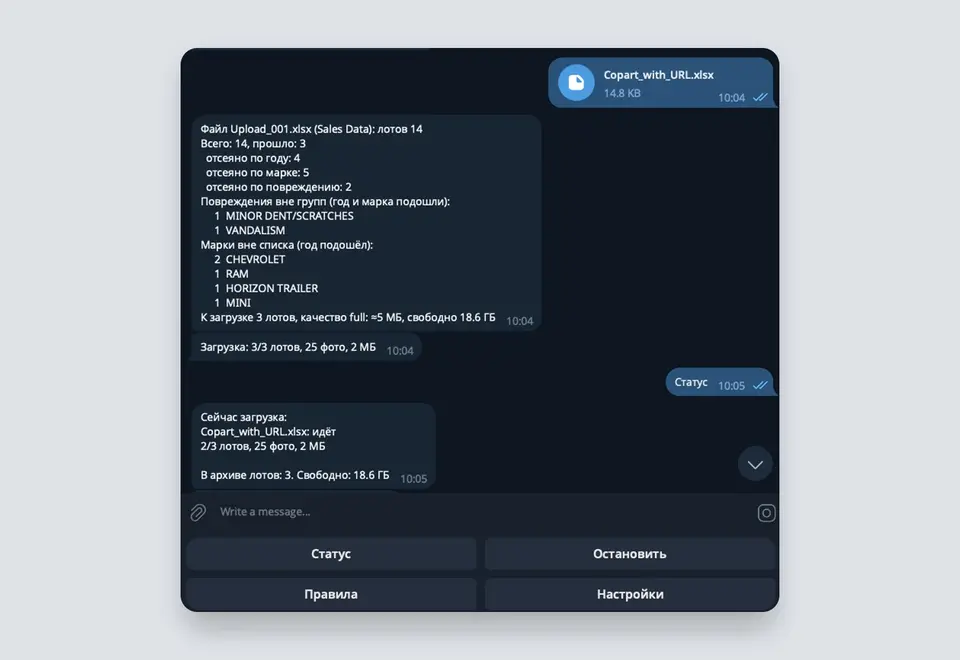
Ein System für einen Kunden, der Fahrzeugschäden aus US-Unfallwagen-Auktionen analysiert. Ziel war es, Fotos von Tausenden Losen zu sammeln und so zu ordnen, dass man mit dem Archiv bequem arbeiten kann. Umgesetzt: • Ein Telegram-Bot: Der Kunde sendet einen Auktionsexport (Excel, CSV oder ZIP), der Bot wählt die passenden Fahrzeuge aus und lädt alle Fotos jedes Loses herunter. • Filter nach Baujahr, Marken und Schadensarten – direkt im Bot per Knopfdruck einstellbar, ohne Entwickler. • Saubere Ablage: Schaden / Marke / Baujahr / Modell / Los_VIN, zu jedem Los eine Datei mit den Daten – VIN, Ausstattung, Schäden, Kilometerstand, Title, Auktionsdatum. Die Quelltabellen bleiben unverändert erhalten, mit Prüfsummen. • Fortschritt in Echtzeit, Stopp und Fortsetzen, keine Duplikate, Prüfung des Speicherplatzes vor jedem Download. • Robust gegenüber echten Excel-Dateien: mehrere Tabellenblätter, CSV aus lokalisiertem Excel, Duplikate, zusätzliche Spalten. • Das Archiv lässt sich unter Windows und macOS als Netzlaufwerk über sicheres SFTP einbinden. • Der Server wird mit einem einzigen Befehl eingerichtet und aktualisiert: Docker, Firewall, Schutz vor Passwort-Brute-Force, Anmeldung nur per Schlüssel. Läuft auf einem VPS mit 1 GB RAM. • 195 automatisierte Tests; ein Deployment stoppt automatisch, wenn auch nur ein Test fehlschlägt. Ergebnis: Aus einem täglichen Export von 50.000 Losen wählt der Bot die relevanten aus und erstellt das Archiv – durchschnittlich 12–13 Fotos pro Fahrzeug, ganz ohne Handarbeit. Stack: Python 3.12, aiogram 3, openpyxl, Docker, Ubuntu, OpenSSH/SFTP, pytest.
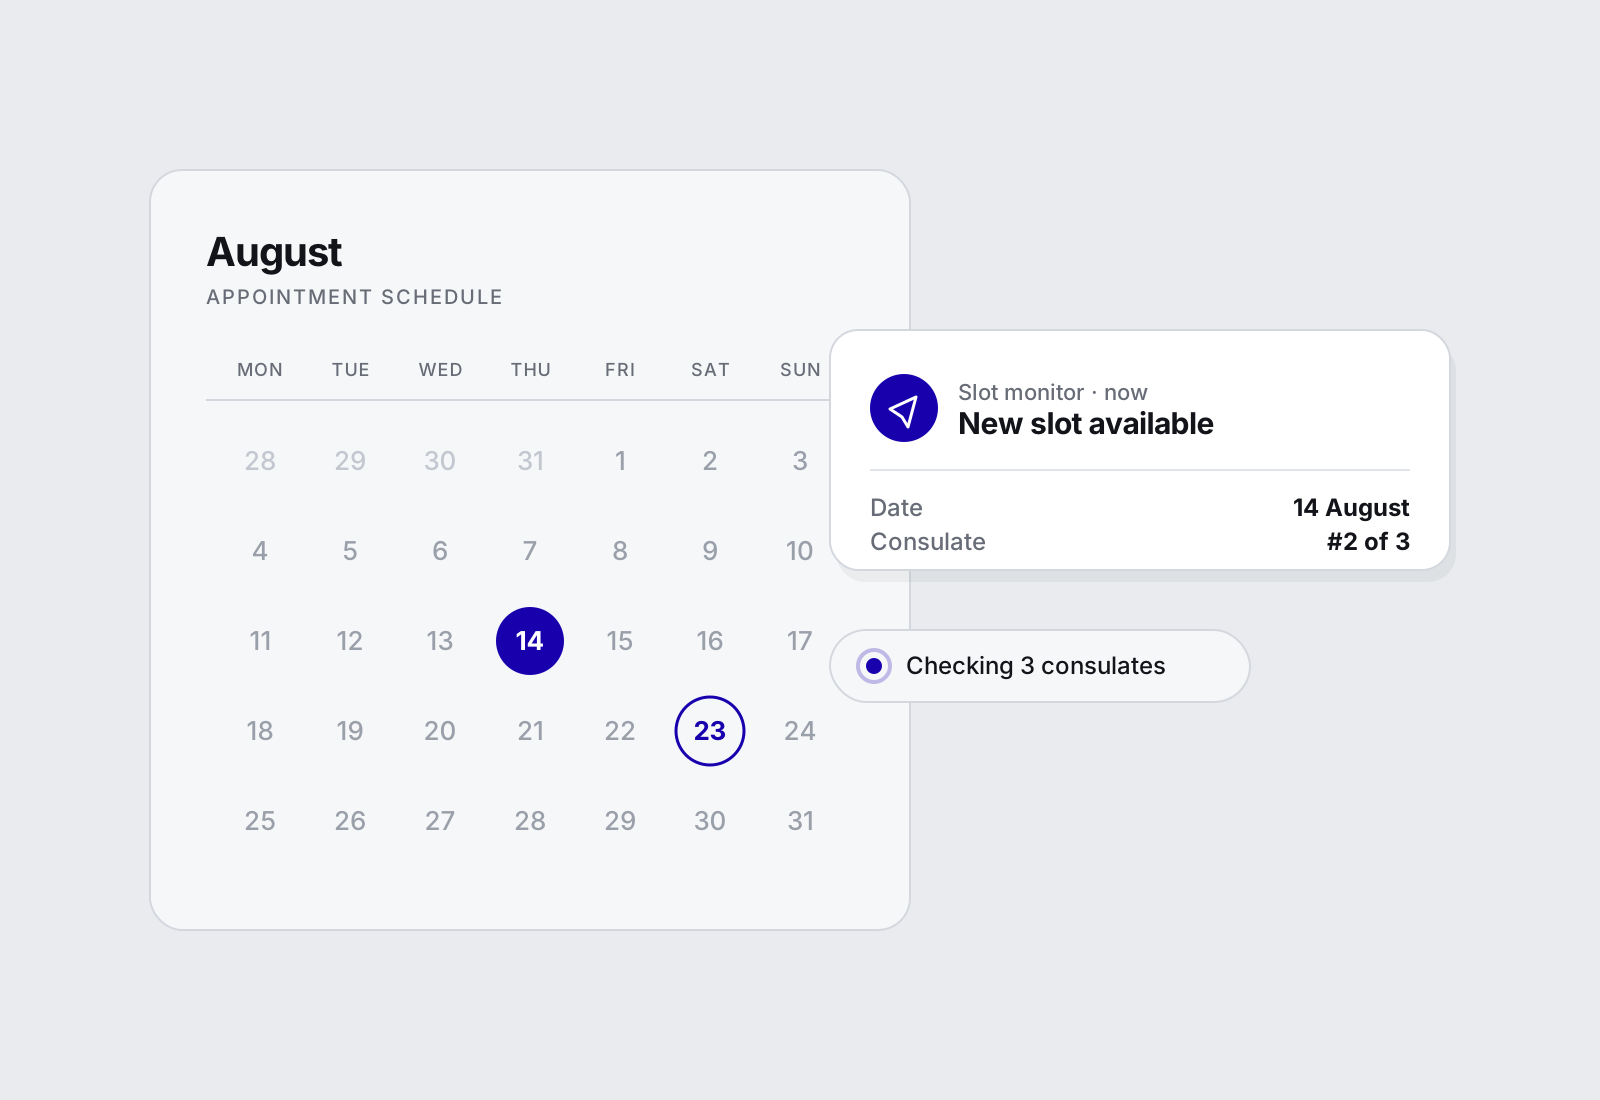
Ein Dienst für einen Kunden, der rechtzeitig von freien Terminen bei litauischen Konsulaten erfahren musste: Termine werden selten frei und sind schnell vergeben. Umgesetzt: • Regelmäßige Prüfung des Online-Terminkalenders für drei Konsulate gleichzeitig. • Telegram-Benachrichtigungen, sobald ein freier Termin erscheint – mit Konsulat und Datum. • Verlauf der gefundenen Termine: was wann frei wurde, ohne doppelte Benachrichtigungen für denselben Termin. • Ausführliche Logs und Screenshots der Seite bei Fehlern – Probleme sind sofort sichtbar. • Migration von Selenium zu Playwright mit asynchroner Architektur: stabiler, schneller und ressourcenschonender. Ergebnis: Der Kunde erfährt Sekunden nach dem Freiwerden von einem Termin und kann ihn rechtzeitig buchen, statt die Seite manuell neu zu laden. Stack: Python, Playwright (zuvor Selenium), asyncio, TinyDB, Telegram Bot API.
Die erste Quelle beginnt beim Betrag unten. Weitere Quellen und die Lieferung in Ihr System werden extra gerechnet.
Preis-, Bestands- oder Katalogbeobachtung von einer Seite.
Ab 300 €
Dieselben Felder von verschiedenen Seiten in einer Tabelle.
Auf Anfrage
Lieferung in Tabelle, CRM oder API und eine Nachricht, wenn ein Lauf steht.
Auf Anfrage
Der erste Monat Support ist enthalten. Danach nach Absprache — wie bei den anderen Leistungen.
Jede Etappe endet mit einem Ergebnis, das Sie prüfen können.
Ja. Eine Quelle deckt eine Seite ab. Die übrigen und die Lieferung in Ihr System kommen extra dazu.
Der Lauf schreibt den Fehler ins Protokoll. Hat sich der Schutz geändert, gehört die Reparatur zum Support-Monat, danach nach Absprache.
Meist ab drei Tagen: Felder, Lauf, Prüfung an echten Seiten und Übergabe.
Erzählen Sie uns von Ihrer Aufgabe – wir melden uns innerhalb eines Tages mit Rückfragen oder einer ersten Einschätzung.